

Obwohl die SAP diese HCM core Erweiterung vor fast 10 Jahren eingeführt hat, fehlt teilweise Klarheit bzgl. Einsatzgebiet und Relevanz des Decoupled Infotype Frameworks (DCIF). Mit dieser Blog-Serie wollen wir dieses Thema aufgreifen und vertiefen.
Worum geht es eigentlich:
Infotypen Aufgabe des Decoupled Infotype Framework ist Infotypen aus der SAP HCM Personaladministration zu lesen oder zu schreiben. Was ist nun eigentlich ein Infotyp? Infotypen werden am häufigsten mit der Mitarbeiterstammdatenpflege via den Transaktionen PA20 und PA30 über den SAPGUI verbunden. Die hier gepflegten Informationen werden von Core HCM Anwendungen wie der Gehaltsabrechnung, Zeitwirtschaft, Backend- oder BI-Berichten sowie ESS und MSS verwendet. Spricht man folglich von Infotypen, wird die Verwaltung von Mitarbeiterdaten gemeint, die gewisse Regeln und Plausibilitäten mit sich bringt.
Eine strukturiertere Definition ist:
Infotypen gruppieren Mitarbeiterinformationen zu logisch und inhaltlich zusammengehörige Entitäten. Diese definieren ferner zusätzliche Regeln und Bedingungen, die auf die reinen Daten Anwendung finden müssen. Aus technischer Sicht bedeutet dies, dass zunächst Daten in einer transparenten Tabelle gespeichert werden, die im Data Dictionary definiert ist. Die einzelnen Tabellenfelder modellieren dabei die Entitäten.
Zusätzlich haben Infotypen eine gemeinsame Schlüsseldefinition, die durch die Struktur PSKEY definiert wird und unter anderem folgende Felder umfasst:
- Personalnummer (PERNR)
- Beginndatum (BEGDA)
- Endedatum (ENDDA)
- Subtyp (SUBTY)
Man könnte jetzt sagen, dass der Begriff Infotyp nur ein spezielles Synonym für Datenbanktabelle ist. Jedoch beinhaltet ein Infotyp im Gegensatz zu einer Datenbanktabelle auch umfangreiche Business Logik sowie eine Kundensicht auf die Daten. Teil der Business Logik ist beispielsweise die Zeitbindung, komplexe Plausibilitätsprüfungen und nicht zuletzt die Visualisierung durch ein geeignetes Benutzerinterface (UI). Ein Infotyp besteht also aus den folgenden Komponenten (gegliedert nach dem Model-View-Controller Architekturmuster):
Model
Daten werden in der Datenbanktabelle PAnnnn gespeichert, deren Inhalt durch die Struktur PSnnnn definiert wird.
View
Im Backend werden Infotypen sowohl durch Modulpool MPnnnn00 als auch durch die Screenstruktur HCMT_BSP_PA_yy_Rnnnn bzw. HCMT_BSP_PA_yy_Rnnnn_LIN_z für den Bereich XSS dargestellt.
Controller
Businesslogik ist in Check-Klassen CL_HRPA_INFOTYPE_nnnnn gekapselt
Und hier liegt das eigentliche Problem
Viele Standard- und Kunden-Infotypen wurden zu einem Zeitpunkt entwickelt, als Software noch nicht nach dem oben genannten MVC-Modell strukturiert wurde. D.h. man findet die gesamte Infotyplogik in einem ABAP-Programm; nämlich dem Modulpool MPnnnn00. Hier ist alles enthalten: Default-Werte, Plausibilitätsprüfungen und Anzeigelogik für den Anwender. Solange man sich in der Welt der Transaktionen PA20 und PA30 bewegt, ist das auch vollkommen ausreichend. Coding für Default-Werte wird im Bereich Process Before Output (PBO) und Coding für Plausibilitäten im Bereich Process After Input (PAI) hinzugefügt. Standard-Infotypen konnten in den Erweiterungen ZXPADUn (siehe PBAS0001) angepasst werden.
Mit der Zeit kam jedoch der Bedarf für einen API-Zugriff hinzu:
- Bei Datenmigrationen müssen Massen von Infotypsätzen automatisch im Hintergrund angelegt werden.
- Drittsysteme via Schnittstellen anzubinden, bedeutet UI-unabhängigen Zugriff auf Infotypen
- Mitarbeiterorientierte Zugriffsvarianten wie ESS und MSS müssen weniger anspruchvolle Oberflächen bereitstellen als die Expertensichten im Backend (Transaktionen PAnn)
Natürlich kann man auch direkt per SQL auf die Datenbank zugreifen. Allerdings interessieren sich SELECT oder INSERT in der Regel nicht für die Business-Logik, die im Modulpool implementiert ist. Auch werden Sperrkonzept und Berechtigungsprüfung umgangen. Aus diesem Grund wurde eine Batch-Input API von SAP bereitgestellt. Dabei werden Eingaben und Operationen via Modulpool verarbeitet. Bekanntester Vertreter hierfür und häufig dazu verwendet ist der Funktionsbaustein HR_MAINTAIN_MASTERDATA. Wozu wird also ein neues Framework benötigt, wenn hier doch so schön der Zugriff schon gekapselt ist?
- Die simulierte Benutzerschnittstelle verursacht insbesondere bei Massenänderungen Performanceprobleme
- Der Batch-Input-Ansatz speichert Infotypen sequentiell. Wie führt man ein Rollback durch, wenn die 7. Änderung auf einen Fehler läuft, die vorausgegangenen 6 Änderungen jedoch bereits mit einem COMIT verbucht worden sind?
- Möchte man eigene Business-Logik hinzufügen, so gibt es dafür keinen strukturierten sauberen Ansatz, so dass Wartungskosten und Fehleranfälligkeiten zunehmen
Zeit für ein Redesign
Als das Thema Concurrent Employment ausgeliefert wurde, sind genau hier Änderungen vorgenommen worden. In einem neuen Architekturansatz wurden Business-Logik (Controller) und Backend Anzeigelogik (View) voneinander getrennt. Es wurde auf ein objektorientiertes Programmiermodell umgestellt; nämlich das Decoupled Infotype Framework. Ebenfalls Bestandteil dieser Umstellung war es, Standard-Infotypen zu entkoppeln. D.h. die Business-Logik wurde von den Modulpools in ABAP Klassen verlagert. Diese Klassen wurden Check-Klassen genannt. Die hier implementierte Business-Logik ist Ereignis gesteuert. Für jedes mögliche Zugriffsszenario wird eine Hook-Methode zur Verfügung gestellt. Die Definition geschieht mittels des Interfaces IF_HRPA_INFTY_BL. Mit der Klasse CL_HRPA_INFOTYPE_NNNN wird eine passende Standardimplementierung dazu ausgeliefert. Also müssen lediglich die zu erweiternden Methoden in einer abgeleiteten eigenen Klasse redefiniert werden. Das folgenden Klassendiagramm soll einen Überblick über die zur Verfügung stehenden Methoden geben:
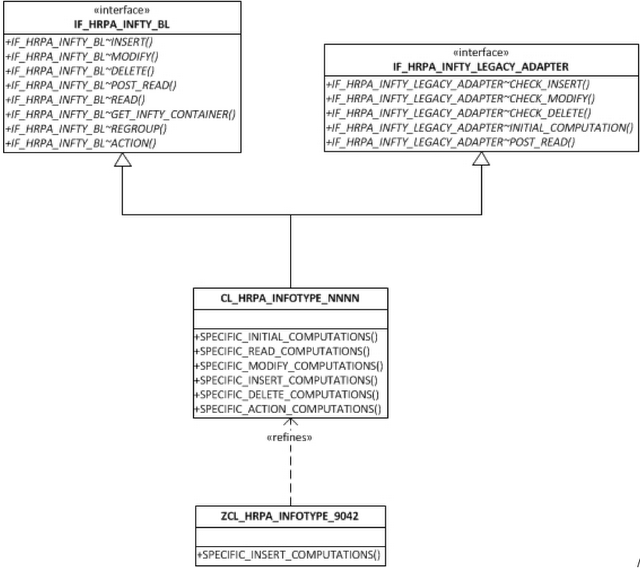 Neben der Architektur zur Implementierung der Business-Logik gibt es noch Klassen für den Zugang zu den Infotypen. Dies wird jedoch in einem späteren Teil dieser Blogserie behandelt. Nach diesem Vorgehen kann die Business-Logik in einen gut strukturierten OO-Kontext gebracht werden. Aber was bedeutet das für die Modulpools? Hierzu zwei Überlegungen:
- Alle XSS-Dienste oder Processes & Forms verwenden ausschließlich das DCIF. Hier werden keine Modulpools mehr verarbeitet bzw. berücksichtigt.
- Die PAnn-Transaktionen benutzen weiterhin die Modulpools und berücksichtigen nicht durchgehend das DCIF.
Gibt es also unterschiedliches Infotyp-Verhalten, je nach dem ob der Benutzer aus dem ESS oder der PA30 zugreift? Es kommt darauf an. Für die PAnn-Transaktionen kann man einstellen, ob das DCIF berücksichtigt werden soll oder nicht. Dies geschieht in zwei Schritten: Schritt 1: In der Tabelle T77S0 (CCURE / PC_UI) kann man mit Hilfe des Schalters PC_UI bestimmen, ob die PAnn-Transaktionen grundsätzlich das DCIF berücksichtigen sollen.
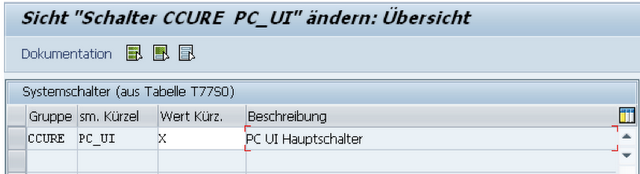
Schritt 2: Im View V_T582ITVCHCK kann dann je Infotyp (und Version) eingestellt werden, ob die Check-Klassen während der Prozessierung des Modulpools gelesen werden sollen. 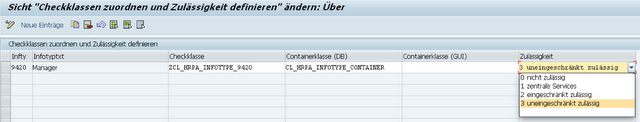
Beim Bewegen von Logik aus den Modulpools in Check-Klassen muss abgewogen werden, dass eventuell im XSS Plausibilitätschecks erforderlich sind, die nicht für PAnn Transaktionen gebraucht werden und umgekehrt. Dies gilt auch für Functionexits und BAdIs, die es in der PA-Infotyp Verarbeitung gibt. Zusammenfassung und nächste Themen In diesem Teil der Blog-Serie wurde der Begriff DCIF vorgestellt und dessen Zweck erläutert. Darüber hinaus wurde der Unterschied zwischen der klassischen PAnn-Welt und den neuen XSS-Szenarien verdeutlicht.
In den kommenden Beiträgen soll der akademische Ansatz verlassen werden und es sollen konkrete Beispiele zu den folgenden Themen folgen:
- Beispiele für Infotypzugriffe mit dem DCIF
- Implementieren eigener Check-Klassen
- Ein Weg durch den Infotyp-BAdI Dschungel
- Problemhandling in Bezug auf die beiden Frameworks

